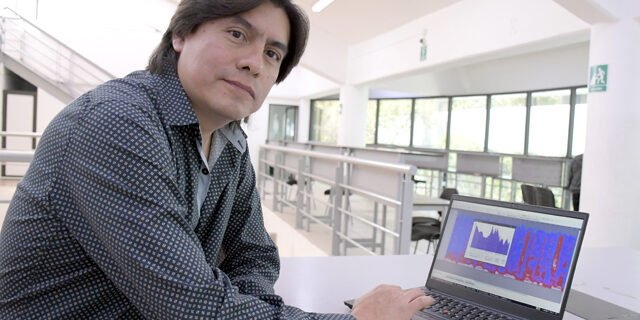
Arturo Olvera López e Iván Olmos Pineda, catedráticos e investigadores de la Facultad de Ciencias de la Computación, participan en el proyecto ZETZOHO-YUHMU Speech Dataset, una iniciativa que busca contribuir al estudio, documentación y preservación de una lengua indígena con pocos recursos lingüísticos disponibles.
El proyecto ZETZOHO-YUHMU Speech Dataset pone a disposición un conjunto de datos de voz orientado a la investigación de lenguas con pocos recursos y en riesgo de desaparición, entre ellas el Yuhmu, una variante de la lengua Otomí.
La iniciativa está enfocada principalmente al desarrollo de tecnologías de reconocimiento automático del habla (ASR) y al análisis de la pronunciación en contextos donde existe una cantidad limitada de información lingüística disponible.
De acuerdo con sus desarrolladores, este repositorio puede sentar las bases para crear sistemas tecnológicos capaces de ofrecer retroalimentación sobre la pronunciación durante el aprendizaje de idiomas, al mismo tiempo que aporta herramientas para la documentación y preservación de las lenguas indígenas de México.
En el proyecto también participan Eric Ramos-Aguilar, Ricardo Ramos-Aguilar y Daniel Sánchez-Ruiz, de la Unidad Profesional Interdisciplinaria de Ingeniería del Instituto Politécnico Nacional, campus Tlaxcala (UPIIT-IPN).
Uno de los principales valores de la iniciativa radica en que el repositorio es de libre acceso, lo que permite que estudiantes, investigadores y desarrolladores puedan utilizar sus datos para avanzar en trabajos relacionados con el procesamiento del lenguaje natural y las tecnologías del habla aplicadas a lenguas indígenas.
Arturo Olvera López destacó que este tipo de recursos pueden ser especialmente relevantes para la comunidad científica, debido a que las lenguas indígenas mexicanas continúan teniendo una representación limitada dentro de las tecnologías de procesamiento del lenguaje natural, pese a contar con comunidades hablantes.
Así, la investigación académica y el desarrollo tecnológico convergen en un mismo objetivo: utilizar la inteligencia artificial y el procesamiento del habla no sólo para innovar, sino también para documentar y contribuir a preservar la diversidad lingüística de México.
El ZETZOHO-YUHMU Speech Dataset puede consultarse de manera abierta en el repositorio del proyecto en GitHub.